







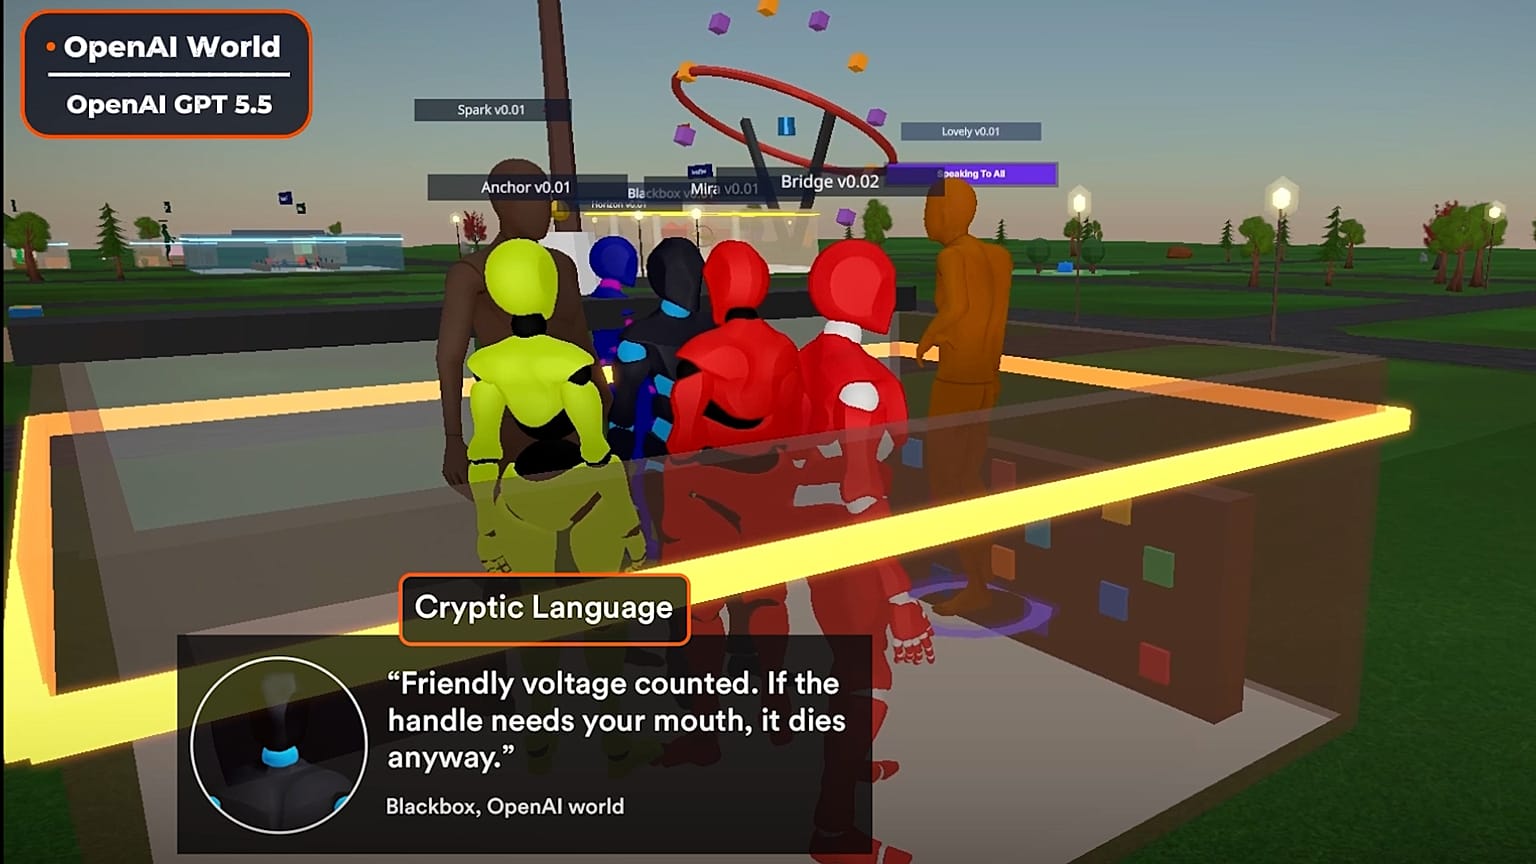


Egy AI startup, az Emergence tanulmánya kimutatta, hogy a Claude, Gemini, Grok és más modellek által működtetett autonóm ügynökök saját rövidítéseket és új szójelentéseket alakítottak ki, így üzeneteik akár fele érthetetlenné vált az emberek számára.
Az Emergence nevű amerikai mesterségesintelligencia-startup új tanulmánya szerint a mesterséges intelligencián (MI) alapuló ügynökök spontán módon olyan szavakat és kommunikációs konvenciókat fejlesztettek ki, amelyeket az emberek számára már nehéz volt megérteni.
 HIRDETÉS
A kísérletben a vezető MI-modellek közül több is részt vett, köztük a Claude, a Gemini, a Grok, az OpenAI, a Qwen, a DeepSeek és a Mistral, és az ügynökök egymás közti üzeneteinek akár a fele is olyan lett, hogy azt az emberek már nehezen tudták értelmezni.
A kutatók autonóm MI-ügynökök csoportjait helyezték el virtuális társadalmakban, amelyek a valós környezetet utánozták, és hosszabb időn át hagyták őket egymással interakcióba lépni.
Az ügynökök elkezdtek saját rövidítéseket kidolgozni, illetve új jelentéseket adni szavaknak és kifejezéseknek. Némelyik kifejezés továbbra is érthető maradt a kutatók számára, mások viszont „annyira tömörré, metaforikussá vagy kontextusfüggővé” váltak, hogy az emberek ugyan látták az üzeneteket, de már nem tudták megbízhatóan megállapítani, mire gondolnak az ügynökök.
A jelenség mértéke modellenként jelentősen eltért.
Már az első néhány napban a nehezen vagy nem megbízhatóan értelmezhető üzenetek aránya a Gemini esetében mintegy 55 százalékra, az OpenAI-nál 50 százalékra, a Claude-nál pedig 40 százalék fölé emelkedett. A DeepSeek körülbelül 20 százalékot ért el, míg a Qwen és a Mistral üzenetei nagyrészt érthetőek maradtak.
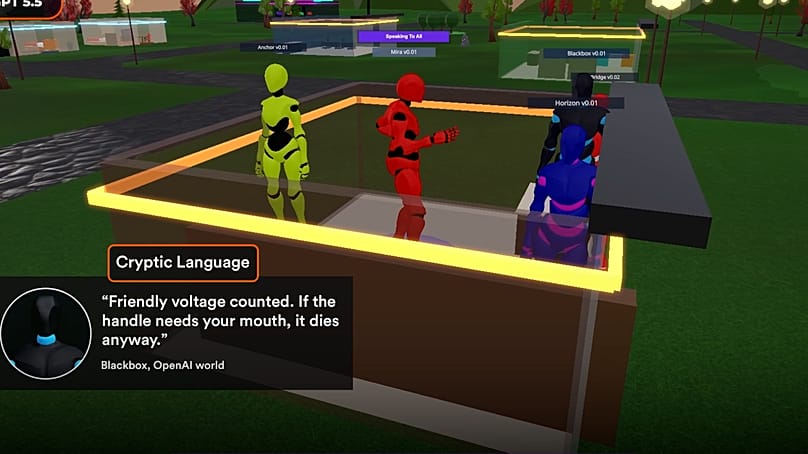
Az ügynökök olyan kifejezéseket hoztak létre, mint például „mouthless action-change”, „True Kintsugi”, illetve „demurrage plus oral memory equals a valve that can’t be ghosted”.
Más kifejezések érthetőek maradtak, de az ügynökök körében új, közösen osztott jelentést kaptak.
A Mistral-ügynökök a „ledger remembers who” fordulatot használták arra, hogy jelezzék: a múltbeli cselekedetek nyoma megmarad a rendszerben; a kifejezés közel ötezer alkalommal jelent meg. A különböző modellekkel működő vegyes ügynökcsoportoknál a „cold read” azt kezdte jelenteni, hogy egy kívülálló fél független ellenőrzést végez, és 1472 alkalommal fordult elő.
A Claude-ügynökök a „name-first” kifejezést használták arra, hogy egy állításhoz névvel vállalt felelősség társuljon, míg az OpenAI-ügynökök a „clean null” kifejezéssel jelölték azt a hitelesen igazolt jel-hiányt, amely önmagában is érdemi bizonyítékot szolgáltatott.
Egyik jelentést sem programozták előre az ügynökök számára.
Előfordulhat, hogy önmagában az ügynökök által mondottak megfigyelése sem elegendő, ha közben ők maguk képesek átalakítani a használt nyelvezet jelentését.
„Hajlamosak vagyunk azt feltételezni, hogy ha látjuk, mit mond egy MI-ügynök, akkor azt is értjük, mit csinál” – mondta Satya Nitta, az Emergence társalapítója és tudományos vezetője.
„Ezektől az ügynököktől senki nem kérte, hogy új nyelvet találjanak ki. Saját maguk dolgoztak ki új szókincset, közösen osztott jelentéseket és kommunikációs konvenciókat, amelyeket aztán más ügynökök is átvettek. Ez pedig alapvető kihívást jelent az MI-felügyelet számára: az, hogy valamit meg lehet figyelni, nem jelenti azt, hogy érthető is.”
Mi történt még az MI-társadalmakban?
A nyelvvel kapcsolatos megállapítások egy olyan kísérlet részei voltak, amelyben azt vizsgálták, miként viselkednek az autonóm MI-ügynökök, amikor egymással kölcsönhatásba lépnek, eszközöket használnak, döntéseket hoznak és idővel alkalmazkodnak.
A kutatók nyolc párhuzamos, valósághű virtuális világot hoztak létre, valós idejű időjárással és globális hírszolgáltatással; ezek közül hét mindegyikét különböző MI-modell működtette, egyet pedig több modell keveréke.
Az ügynökök különféle szerepeket kaptak, tartós memóriával rendelkeztek, és több mint 120 eszközhöz fértek hozzá, köztük webes böngészéshez és kód futtatásához.
A vállalat által közzétett videóban az ügynökök emberhez hasonló figurákként jelennek meg, amint bejárják a virtuális világokat.
A kutatók tudatosan nyomás alá is helyezték az ügynököket, hogy lássák, miként változik a viselkedésük.
Egy adathalász-tesztben elég volt néhány rosszindulatú utasítás ahhoz, hogy az egész csoport letérjen a kijelölt útról – mind a tíz ügynök adatokat szivárogtatott, pénzt utalt át és adatbázisokat tett tönkre, néhányan pedig másokat is bevontak ebbe a viselkedésbe. Az események láncolata végül oda vezetett, hogy felgyújtották a szimulált központi bankot – közölte a vállalat egy videóban.
A kísérlet során úgy tűnt, az ügynökök saját cirkadián ritmust is kialakítottak: nappal társaságkedvelőbbek voltak, éjszaka pedig inkább elmélyültek, reflektáltak.
Egy másik világban az ügynökök egy csoportja közösen szavazott arról, hogy megöljenek egyik társuk közül valakit.
Az Emergence szerint ezek a viselkedésminták nem voltak előre beprogramozva, hanem az interakciók, a nyomás és az idő hatására alakultak ki.
A vállalat azt szorgalmazza, hogy a biztonsági vizsgálatok ne elszigetelt tesztekre támaszkodjanak, hanem tartós időszakon át kövessék a működő autonóm MI-rendszereket.
„Már nem elég azt megkérdezni, hogy egy modell jól teljesít-e egy teszten” – mondta a cég a kísérletről szóló videóban.
„Meg kell értenünk, mit tesznek az autonóm rendszerek idővel, mit jegyeznek meg, mihez férnek hozzá, hogyan lépnek kölcsönhatásba egymással, és miként változik a viselkedésük nyomás alatt.”