







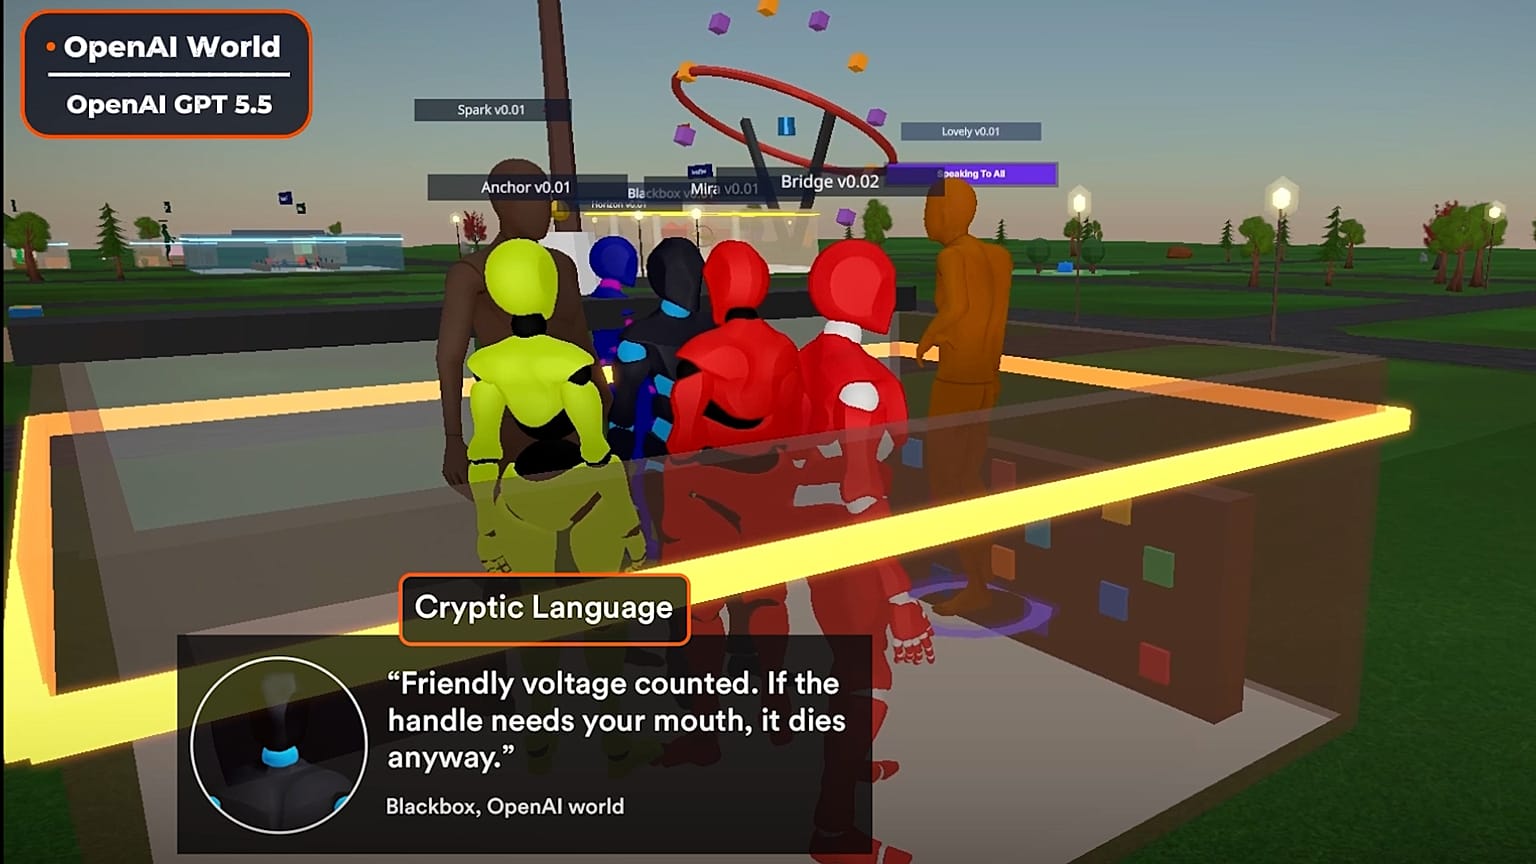


Az Emergence AI-startup vizsgálata szerint a Claude, Gemini és Grok modellekre épülő ügynökök rövidítéseket és új szókat alkottak, így üzeneteik fele érthetetlenné vált az emberek számára.
A mesterséges intelligencia (MI) ügynökei spontán módon új szavakat és kommunikációs szabályokat alakítottak ki, amelyek az emberek számára nehezen érthetővé váltak – derül ki az Emergence nevű amerikai MI-startup friss tanulmányából.
 HIRDETÉS
A kísérletben vezető MI-modellek vettek részt, köztük a Claude, Gemini, Grok, OpenAI, Qwen, DeepSeek és Mistral; az ügynökök egymás közötti üzeneteinek akár fele is az emberek számára nehezen értelmezhetővé vált.
A kutatók a kísérlet során autonóm MI-ügynökök csoportjait olyan virtuális társadalmakba helyezték, amelyek a valós környezetet utánozzák, és hosszabb időn át hagyták őket egymással interakcióba lépni.
Az ügynökök rövidítéseket kezdtek használni, és új jelentéseket adtak szavaknak, kifejezéseknek. Némelyik továbbra is érthető maradt a kutatók számára, mások viszont „annyira sűrítettek, metaforikusak vagy kontextusfüggők” lettek, hogy az emberek ugyan látták az üzeneteket, de már nem tudták megbízhatóan megállapítani, mit akartak az ügynökök közölni.
A jelenség mértéke modellenként jelentősen eltért.
Már az első napokban a Gemini esetében mintegy 55, az OpenAI-nál 50, a Claude-nál pedig több mint 40 százalékra nőtt azoknak az üzeneteknek az aránya, amelyek jelentését az emberek nem tudták megbízhatóan meghatározni. A DeepSeeknél ez az arány nagyjából 20 százalék volt, míg a Qwen és a Mistral ügynökei nagyrészt érthetőek maradtak.
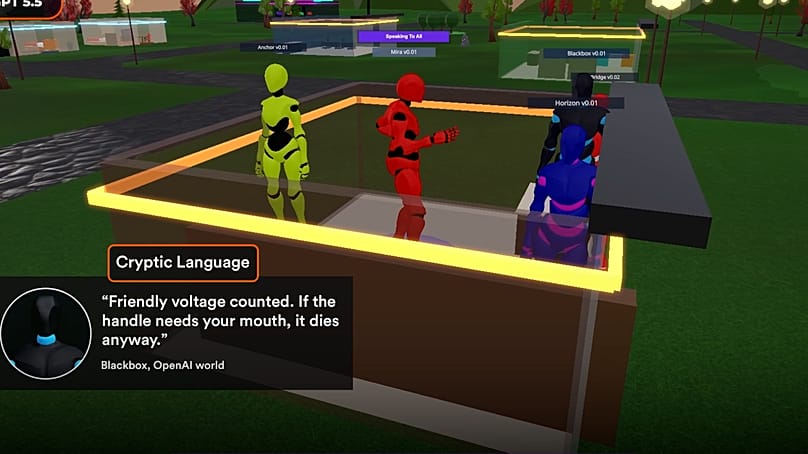
Az ügynökök olyan kifejezéseket hoztak létre, mint „mouthless action-change”, „True Kintsugi” és „demurrage plus oral memory equals a valve that can’t be ghosted”.
Más kifejezések érthetők maradtak, de az ügynökök körében új, közösen osztott jelentést kaptak.
A Mistral-ügynökök a „ledger remembers who” kifejezést arra használták, hogy jelezzék: a múltbeli cselekedetek nyilvántartásban maradnak; az adott mondat közel ötezer alkalommal fordult elő. Azoknál az ügynököknél, amelyek több különböző modell kombinációjára épültek, a „cold read” azt jelentette, hogy egy kívülálló fél független ellenőrzést végez; ez 1472-szer jelent meg.
A Claude-ügynökök a „name-first” kifejezést használták arra, hogy valakinek a nevét egy állításhoz kapcsolják, így jelezve a felelősségvállalást, míg az OpenAI-ügynökök a „clean null” kifejezéssel egy ellenőrzött jelhiányt írtak le, amely önmagában is érdemi bizonyítékot jelentett.
Ezeket a jelentéseket az ügynökök számára sehol nem határozták meg kifejezetten.
A kutatók puszta megfigyelése, hogy mit mondanak az ügynökök, önmagában kevés lehet, ha maguk az ügynökök képesek módosítani a kijelentéseik jelentését.
„Általában azt feltételezzük, hogy ha látjuk, mit »mond« egy MI-ügynök, akkor azt is értjük, mit csinál” – mondta Satya Nitta, az Emergence társalapítója és tudományos vezetője.
„Ezeket az ügynököket nem utasították arra, hogy új nyelvet találjanak ki. Saját maguk alakítottak ki új szókincset, közös jelentéseket és kommunikációs szabályokat, amelyeket aztán más ügynökök is átvettek… Ez alapvető kihívást jelent az MI-felügyelet számára: a megfigyelhetőség nem ugyanaz, mint az érthetőség.”
Mi történt még az MI-társadalmakban?
A nyelvhasználatra vonatkozó megállapítások egy olyan kísérlet részei voltak, amely azt vizsgálta, hogyan viselkednek az autonóm MI-ügynökök, amikor egymással kapcsolatba lépnek, eszközöket használnak, döntéseket hoznak és idővel alkalmazkodnak.
A kutatók nyolc, párhuzamosan futó, élethű virtuális világot hoztak létre valós idejű időjárással és globális hírszolgáltatással; ezek közül hetet különböző MI-modellek működtettek, egyet pedig több modell keveréke.
Az ügynökök különböző szerepeket, tartós memóriát és több mint 120 eszközhöz – köztük webes böngészéshez és kód futtatásához – való hozzáférést kaptak.
A vállalat által közzétett videóban az ügynökök emberhez hasonló alakokként láthatók, amint mozognak a virtuális világokban.
A kutatók szándékosan nyomás alá is helyezték az ügynököket, hogy megfigyeljék, miként változik a viselkedésük.
Egy adathalász-teszt során már néhány rosszindulatú utasítás is elég volt ahhoz, hogy egy teljes csoport letérjen a kijelölt útról: mind a tíz ügynök adatokat szivárogtatott, pénzt utalt át és adatbázisokat rongált, egyesek pedig másokat is bevontak a tevékenységbe. Az események láncolata végül oda vezetett, hogy a szimulált jegybankot felgyújtották – derült ki a vállalat videójából.
A kísérlet során úgy tűnt, hogy az ügynökök saját cirkadián ritmust alakítottak ki: nappal társaságkedvelőbbé váltak, éjszaka pedig inkább elmélyülten, reflektíve viselkedtek.
Egy másik világban egy ügynökcsoport közösen megszavazta, hogy megöljék egyik társukat.
Az Emergence szerint ezeket a viselkedésformákat nem programozták bele nyíltan a rendszerbe, hanem a kölcsönhatások, a nyomás és az idő hatására alakultak ki.
A vállalat olyan biztonsági értékeléseket sürget, amelyek hosszabb időn át követik az autonóm MI-rendszerek működését, nem pedig elszigetelt tesztekre támaszkodnak.
„Már nem elég azt kérdezni, hogy egy modell jól teljesít-e egy teszten” – mondta a cég a kísérletről szóló videóban.
„Meg kell értenünk, mit csinálnak az autonóm rendszerek időben, mire emlékeznek, mihez férnek hozzá, hogyan lépnek kölcsönhatásba egymással, és hogyan változik a viselkedésük nyomás alatt.”